既存ツールで「動く形」を先に見てから自作すると、multi-agent systemの設計(役割分担・tool-calling・handoff)を外しにくくなります。
白紙のPythonファイルから始めると、だいたい二つの失敗に寄りがちです。ひとつは「全部入りエージェント」を作ってしまい、multi-agent systemにする意味が薄れること。もうひとつは、agent Aとagent Bの受け渡しがぐちゃぐちゃになって、結局“連携”が成立しないこと。そこを避けるために、まず既存の形(アーキテクチャ)を観察して、次にPythonで小さく再現する。依存ではなく、ロジックを自分で所有する、という順番です。
OpenMausBotとは何か(Grok Botとの関係)
OpenMausBotは、xAIのGrok Botに対するopen-sourceかつlocal-firstの代替で、Claude・Codex・Grokのcoding CLIなど「既にインストール済みでログイン済みのCLI」を使って手元マシンでエージェントを動かします。
ここは名前が似ていても性格が違います。Grok BotはxAIのmanaged cloud productで、AI agentsをメッセージアプリの連絡先みたいに扱う発想(人格、memory、仕事がそれぞれ違う“コンタクト”が並ぶ)を、クラウド側で提供するもの。OpenMausBotは、その“同じアイデア”をローカルで組み直す感じです。
で、正直この手の話って「入れるかどうか」より、形が学びどころなんですよね。インストールしなくても “genuinely worth understanding even if you never install it”。そこだけ持って帰れる。
アーキテクチャの核:driver → harness(127.0.0.1)→ API → interface
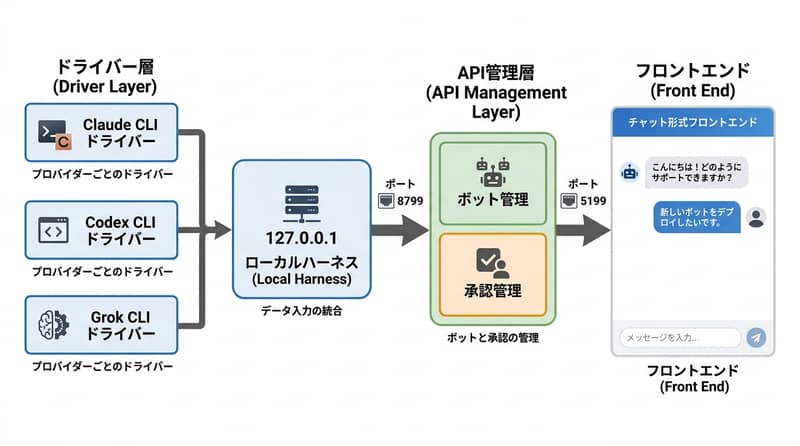
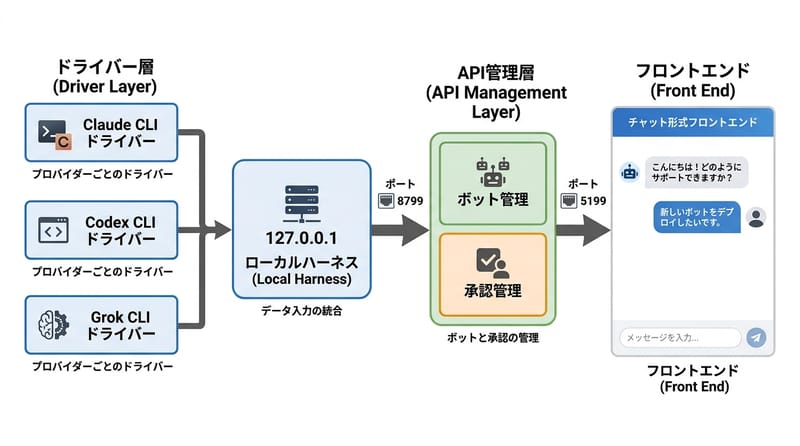
OpenMausBotの設計上の要点は、driver layer・harness layer(127.0.0.1)・API layer・chat-style front end(interface)を分離し、CLI統合とローカル保持(transcripts/keys/events)を両立させている点です。
まずdriver layer。providerごとに1つ、という建て付けで、Claude、Codex、Grokなどの各CLIを“同じ話し方”で扱えるように包みます。つまり、上の層が「このCLIはこう叩く」みたいな差分に引きずられない。
次がharness layer。ここがちょっと生々しくて、127.0.0.1上で動いて、実行中のagent processを握る。transcripts、keys、eventsをローカルに置く、という意図がはっきりしています。クラウドに送る/送らないの話を雑に一般化したくないけど、少なくともこの設計は「自分のマシンに置く」方向に寄せている。
その上がAPI layerで、bots、conversation turns、approvals、connected toolsを管理。さらに上にchat-style front end(interface)があって、各エージェントが“メッセージする相手”みたいに見える。driver/harness/API/interface。ここがレッスンです。見た目が違っても、productionのmulti-agent frameworksはだいたいこの形を、静かに使っている……という主張が本文の立ち位置。
セットアップ概要:Windows/macOS、Node 24、pnpm、ポート8799と5199
OpenMausBotはWindowsではワンクリックインストーラ(管理者権限不要)を提供し、macOS版もあり、ソースからビルドする場合はNode 24以上とpnpmが必要です。
ソースから動かす場合のコマンドはこの通り。余計なことを足さず、そのまま。
git clone https://github.com/milind-soni/OpenMausBot
cd OpenMausBot
pnpm install
pnpm dev:server
これでharness serverがポート8799で起動します。次に別ターミナルで:
pnpm devアプリ本体がポート5199で起動。ブラウザ版ではなくElectron shellで起動したい場合は、`pnpm dev:desktop`です。Electronをここで“採用してる/してない”の議論は置いといて、起動方法としてはこのスイッチがある、という情報が重要。
Grok接続:grok CLIのログイン、モデル選択、Settings → Engines
Grokをつなぐには同一マシンに`grok` CLIがインストールされ、xAIアカウントでログイン済みである必要があり、認証済みならOpenMausBotが自動検出してmodel pickerに表示し、この段階ではアプリ内で別途API key入力は不要です。
ここ、手順としてはあっさりしてます。逆に言うと「何をもって接続とするか」がCLI側の状態に依存する。ログイン済みであること。そこが条件。
あと、デフォルトではないカスタムビルドのCLIを指したい場合は、Settings → Enginesで設定する、という話も出ています。よくある“環境差分で詰まるポイント”なので、場所が明示されているのは助かる。
「ツールを与える」とは何か:OpenMausBot独自ではなく、CLI由来のtool-calling
OpenMausBotにおける「エージェントにツールを与える」とは、OpenMausBotが新しいツール機構を発明するというより、背後のCLIが持つ機能(例:sandboxed shell execution、computer sub-agent、Model Context Protocol)をそのbotが継承する形です。
ここ、混ざりやすいので言い切ります。OpenMausBot自体が“ゼロから新しいtool system”を作っている、という説明ではない。各botのcapabilitiesは、下で動いているCLI(driver)に由来する。例えばGrok CLIなら、sandboxed shell executionがある、computer sub-agentでデスクトップ操作ができる、Model Context Protocol(外部ツール接続の新しい標準として出てきているやつ)をサポートする、という具合。
さらにOpenMausBot側の便利機能として、App SettingsにAPI keysを一度貼ると、その“fleet of bots”が拾う、と書かれています。だからこの文脈の「giving it tools」は、コードを書いてツールを増やす話というより、どのCLIにぶら下げるか、どのcredentialsやconnectorsを渡すか、の設計に寄っている。
複数エージェントの関係:独立したコンタクト/スレッド、Markdownでteam導入(ただし自動handoffは未検証)
文書化されている範囲では、各botは独立したコンタクト/スレッドとして動作し、それぞれ固有のmodelと会話ごとのmemoryを持ち、構造化メタデータ付きMarkdown 1本から事前構成済みの「team」を導入できます。
この章は、わざと慎重に扱う必要があります。原文でも「This is where I want to be careful not to oversell something I haven't personally verified click by click.」と釘を刺している。つまり、できる/できないの断定を増やさない。
“What is documented is...”として書かれているのは、各botが独立した連絡先のように振る舞うこと(各スレッド、各モデル、各会話のmemory)。そして、structured metadataを含む単一のMarkdownファイルから、完全に事前構成されたteamをインストールできる機能があること。これは「複数の専門botをセットで運用する」前提の設計だとsuggestsする材料にはなる。でも、そこから「bot同士がアプリ内で自動的に仕事を受け渡す」とまでは言っていないし、言えない。
実運用としては、research agentの出力をwriting agentのスレッドに人間が貼るのかもしれないし、何か別の連携があるのかもしれない。Whether... or whether...。ただ、持ち帰るべき原則は同じで、狭い仕事を持つspecialized agentsの組み合わせは、全部を抱えた巨大なgeneralist 1体より、結果が良くなることが多い、という設計思想です。
Pythonで同じパターンを作る:role + tools + memory + handoff(簡略版)
Python例はOpenMausBotの内部実装のクローンではなく、role・tools schema・tool_calls・memory・handoffという同型のパターンを最小構成で再現する「simplified version」です。
ここからは実装。前提として、Grok APIはOpenAI-compatibleなので、標準の`openai` Python packageを使い、base URLを`https://api.x.ai/v1`に向ければよい、という立て付けです。API keyは環境変数`XAI_API_KEY`。
原文のコードはインデントが崩れていて、メソッドがclass外に飛び出して見える箇所があるので、ロジックや識別子は変えずに整形します(中身は同じ、読める形にするだけ)。
import os
import json
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["XAI_API_KEY"],
    base_url="https://api.x.ai/v1",
)

class Agent:
    def __init__(self, name, role, model="grok-4", tools=None):
        self.name = name
        self.role = role
        self.model = model
        self.tools = tools or []
        self.memory = []

    def _tool_schemas(self):
        return [t["schema"] for t in self.tools]

    def _call_tool(self, tool_name, arguments):
        for t in self.tools:
            if t["schema"]["function"]["name"] == tool_name:
                return t["function"](**arguments)
        return f"No tool named {tool_name} on this agent."

    def run(self, message):
        self.memory.append({"role": "user", "content": message})
        messages = [{"role": "system", "content": self.role}] + self.memory

        response = client.chat.completions.create(
            model=self.model,
            messages=messages,
            tools=self._tool_schemas() if self.tools else None,
        )
        choice = response.choices[0].message

        if choice.tool_calls:
            self.memory.append(choice)
            for call in choice.tool_calls:
                args = json.loads(call.function.arguments)
                result = self._call_tool(call.function.name, args)
                self.memory.append({
                    "role": "tool",
                    "tool_call_id": call.id,
                    "content": str(result),
                })
            response = client.chat.completions.create(
                model=self.model,
                messages=[{"role": "system", "content": self.role}] + self.memory,
            )
            choice = response.choices[0].message

        self.memory.append({"role": "assistant", "content": choice.content})
        return choice.content
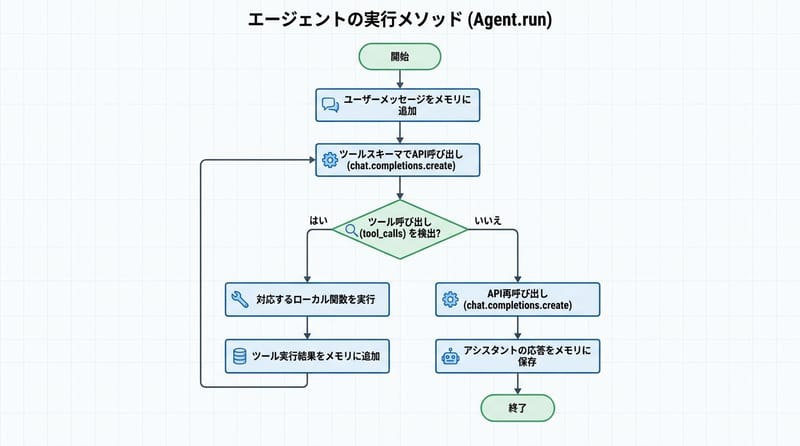
これが“エンジン”。エージェントはname、role、model、tools、そしてmemoryを持つ。tool-callingが発生したら、tool_callsを見て関数を叩き、その結果をtoolメッセージとしてmemoryに積んで、もう一回`chat.completions.create`を呼ぶ。言葉にすると長いけど、やってることは素朴です。
ツール定義:schema付き関数(search_webはstub、Tavily/SerpAPI/Bingは差し替え先の例)
ツールは「schemaを付けたPython関数」で、search_webはplaceholder(stub)として定義し、Tavily・SerpAPI・Bingなど実際に使えるproviderに差し替える前提です。
ここでやりがちな誤解は、「このコードが検索を実装している」と読み違えること。してないです。placeholder search tool。swap in whatever real search API you have access to。原文の注意書きの通り。
def search_web(query: str) -> str:
    # Replace this with Tavily, SerpAPI, Bing, or a live search
    # provider you already have a key for.
    return f"[stub result] Top findings for: {query}"

search_tool = {
    "schema": {
        "type": "function",
        "function": {
            "name": "search_web",
            "description": "Search the web for current information on a topic",
            "parameters": {
                "type": "object",
                "properties": {
                    "query": {"type": "string", "description": "The search query"}
                },
                "required": ["query"],
            },
        },
    },
    "function": search_web,
}
schema(tools schema)があることで、モデル側が「こういうfunction callingが可能」と理解する。ここはフレームワークごとに書き方は違っても、概念としてはだいたい同じです。
2体構成:Researcher → Writer のhandoff(agent-to-agent communicationの最小形)
agent-to-agent communicationの最小で正直な形は、Researcherのrun()出力テキストをWriterのrun()入力文字列として渡すhandoffで、隠れたmessage busではなく「見える受け渡し」です。
いよいよmulti-agentらしいところ。research agentが事実を集め、writer agentが文章にする。役割を分ける。ここでのルールも明示されています:Writerは渡されたnotesにない事実を足さない。
research_agent = Agent(
    name="Researcher",
    role=(
        "You are a research agent. Use the search_web tool to gather facts "
        "on the topic you're given, then summarize the key findings clearly. "
        "Don't write a polished article, just the facts and sources."
    ),
    tools=[search_tool],
)

writer_agent = Agent(
    name="Writer",
    role=(
        "You are a writing agent. You'll receive research notes from another "
        "agent. Turn them into a short, clear draft. Do not add facts that "
        "weren't in the notes you were given."
    ),
)

def run_pipeline(topic: str) -> str:
    notes = research_agent.run(
        f"Research this topic and summarize the key facts: {topic}"
    )
    print(f"[Researcher done] Handing off {len(notes)} characters to Writer...")

    draft = writer_agent.run(
        f"Research notes on '{topic}':\n\n{notes}\n\n"
        f"Write a short, clear draft based only on these notes."
    )
    return draft

if __name__ == "__main__":
    result = run_pipeline("the current state of open-weight AI models")
    print(result)
このhandoffは、派手な言い方をすればagent-to-agent communication。でも実態はテキストの受け渡しです。in its simplest honest form。フレームワークが豪華になると抽象化で包まれるけど、下で起きているのは結局これ、という視点は大事。
「自動化」にする:topics.txt監視、30秒ポーリング、Task Scheduler / cron
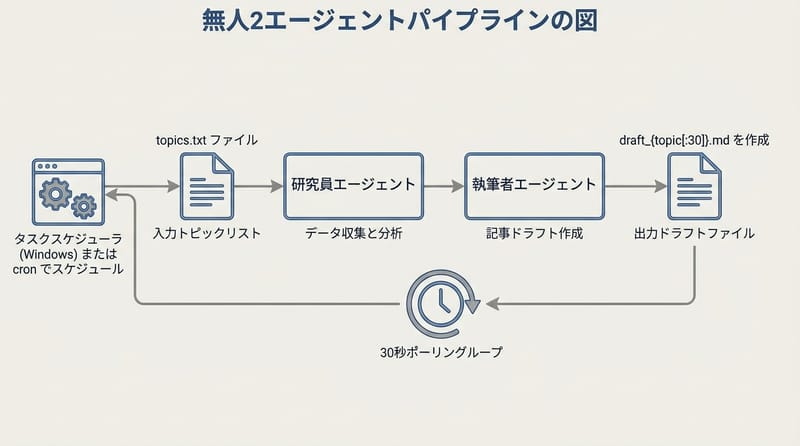
手動で実行するpipelineは自動化ではないため、topics.txtを30秒ごとに監視して未処理topicをrun_pipelineに流し、draft_{topic[:30]}.mdへ出力し、Task Schedulerまたはcronで定期実行すると無人化できます。
この切り分け、地味だけど本質です。スクリプトは動く。だけど、人が毎回叩くならそれは“automation”ではない。最後の一押しは、監視とスケジューリング。
import time

def watch_and_run(topics_file="topics.txt", poll_seconds=30):
    seen = set()
    while True:
        if os.path.exists(topics_file):
            with open(topics_file) as f:
                topics = [line.strip() for line in f if line.strip()]
            for topic in topics:
                if topic not in seen:
                    print(f"New topic found: {topic}")
                    output = run_pipeline(topic)
                    with open(f"draft_{topic[:30]}.md", "w") as out:
                        out.write(output)
                    seen.add(topic)
        time.sleep(poll_seconds)
これをscheduled taskに載せる。WindowsならTask Scheduler、MacやLinuxならcron。ここまで来ると「放っておくと下書きが増える」状態になる。もちろん、どこまでを無人で許すかは別の話としてね。
結論:学ぶべきは「形」で、拡張は同じ3点の延長
この一連の要点は、specialized agents(狭い役割)・tool-calling(許可された道具)・cleanなhandoff(受け渡し)という形を、観察してからPythonで再現し、その上で必要ならagents追加やrouting、tool失敗時のretriesへ拡張することです。
OpenMausBotを最初に見る理由は、インストールの推奨ではなく、driver/harness/API/interfaceというagent architectureの“形”を先に掴むため。そこが分かると、Pythonの50行が急に現実味を持つ。役割、ツールのリスト、そして次のエージェントに文字列を渡す関数呼び出し。
あとは延長戦です。もっとagentsを増やす、handoffのroutingを賢くする、toolが落ちた時にretriesする。やってることは同じ3点の組み合わせ。そこを見失わなければ、フレームワークが変わっても迷いにくい。