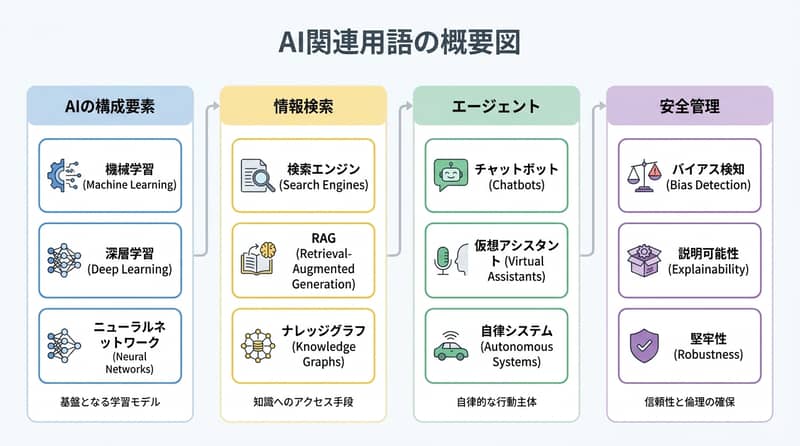
AI用語は「何をするか・何に触れられるか・誰が間違いを止めるか」の3点で見れば、だいたい整理できる。
会議とかプロダクト説明って、普通の単語が3つ続いたと思ったら、急に略語が14個出てくる。で、みんな分かった顔をする。…いや、分かってない時もある。
ここは研究者向けの厳密な教科書じゃない。ニューラルネットの設計で深夜に勝つための武器でもない。ミーティングに置いていかれない、プロダクトページを読める、そして「新しい帽子をかぶった昔の概念」を見抜ける。そのための、日常語としての意味のまとめ。
注意点は一つ。AIの言葉は動くし、会社によって同じ単語を少し違う意味で使うことがある。なのでここでは「現場で通じやすい」ほうに寄せる。
まずは土台:モデルと入出力の基本
生成系の会話で頻出するのは、Generative AI / foundation model / LLM / prompt / token / context windowあたりで、ここを押さえると後半の略語が薄味になる。
で、いきなりだけど用語って、定義より「何ができて、何ができないか」をセットで覚えるほうがラク。
1. Generative AI(生成AI):テキスト、画像、音楽、動画、コードなど「新しいもの」を作るAI。大量の既存データからパターンを学び、それっぽい形で出力する。ただし、うまく言えることと、真実であることは別。例として、税理士がExcelでドラゴンと戦う寝物語だって、四半期決算っぽく捏造できる。
2. Foundation model(基盤モデル):広く学習された大きなモデルで、いろいろな仕事に適応できる土台。ピザ生地みたいなもの、という比喩が近い。生地だけでも食べられるけど、普通は具や形を変えて製品になる。ある会社はカスタマーサポートに、別の会社は「プリンターがなぜ暴れているか」を説明させる、みたいに。
3. LLM(Large Language Model):大量のテキストで学習し、言語を扱うモデル。内部的には「次に来そうなテキストの塊」を予測してつなぐ。ChatGPT、Claude、GeminiはLLMを使ったプロダクト。要するに、巨大な図書館を読んだオートコンプリート。
4. Multimodal model(マルチモーダル):テキストだけでなく画像・音声・動画など複数の形式を扱えるモデル。「説明する」だけじゃなく「見せる」もできる。レシート写真を投げて「どっちが小さな王族みたいな注文した?」みたいな。
5. Prompt(プロンプト):AIに渡すもの全部。質問、指示、例、背景。入力が良いほど出力が使える確率は上がる。「ローマで安い週末旅行、朝6時のフライトはなし、睡眠が好き」みたいな具体がプロンプト。「ローマ?」は…助けを求める叫びに近い。
6. System prompt(システムプロンプト):アプリ側が裏で渡す「振る舞いのルール」。口調、役割、制限、やってはいけないことを決める。ユーザーのプロンプトが注文なら、システムプロンプトは厨房の方針。「靴なし、シャツなし、揚げ物機を燃やすな」みたいなやつ。
7. Prompt engineering(プロンプトエンジニアリング):モデルが安定して役に立つように、指示を設計する作業。魔法の言葉探しというより、目的・文脈・形式・例を明確にする。「良くして」だと霧が出る。「120語の歓迎メール、温かいが甘すぎない、次の一手は1つ」だと地図になる。
8. Token(トークン):モデルが読むテキストの小片。単語丸ごとのことも、単語の一部や句読点のこともある。コンテキスト上限や料金は、普通の「単語数」ではなくトークンで数えられることが多い。「cat」は軽装、「antidisestablishmentarianism」はスーツケース6個。
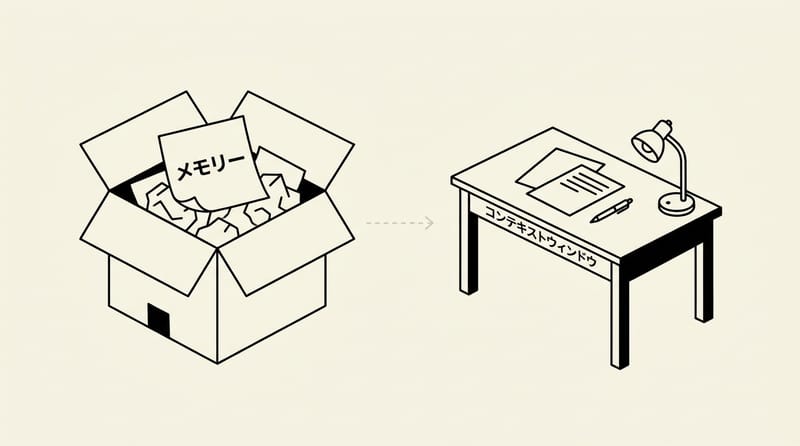
9. Context window(コンテキストウィンドウ):モデルが一度に考慮できる情報量。机の広さ、みたいに考えると分かりやすい。広いほどメモを置けるが、積みすぎると古い情報が端から落ちたり無視されたりする。80ページ前にブランドボイスを説明しても、今は「friendly」だけ覚えていて他を落としている、みたいな。
10. Context engineering(コンテキストエンジニアリング):その机に「何を」「いつ」置くか、何を外すかを設計すること。プロンプト、検索で取ってきた文書、ツール結果、メモリーも含む。プロンプトエンジニアリングが「良い質問を書く」なら、こっちは「400個の関係ないファイルをどかしてから質問する」。地味。効く。
11. Inference(推論):学習済みモデルを実際に使って答えを出す瞬間。学習は学校、推論は出勤。キャンペーン案を3つ聞いて返ってくる、その瞬間が推論。返ってきた案が全部「Unlock your potential」なら、それは月曜。
12. Temperature(温度):出力の予測可能性とバラつきを変える設定。低いと安全で一貫しやすい、高いと意外性が出る。IQのつまみではない。低温は慎重な会計士、高温は昼休みに即興劇へ行く会計士。
13. Reasoning model(推論・推論特化モデル):計画、論理、数学、コードなど多段の問題で、より計算を使うよう設計されたモデル。返答まで少し待つことがある。とはいえ、待ったから自動的に正しいわけではない。伝票計算でナプキンを求める友人、みたいな立ち位置。
情報の扱い:当てずっぽうを減らす言葉
Hallucination / grounding / embedding / vector database / RAG / fine-tuningは、「モデルがどこから何を持ってきて答えるか」を理解するためのセット。
このへん、派手に見えるけど、要点はわりと渋い。情報の出どころを増やす。形を整える。間違いの確率を下げる。…ただ、ゼロにはならない。
14. Hallucination(幻覚、confabulation):もっともらしいが、誤り・根拠なし・捏造の回答。モデルは「それっぽい言語」を出すように作られていて、架空の判例を作っても恥ずかしがらない。存在しないパリのカフェを、営業時間付きで勧める、みたいな。
15. Grounding(グラウンディング):回答を検証可能な情報(自社文書、DB、ライブ検索結果など)に結びつけること。捏造は減らせるが、悪いソースは悪い答えを作る。返金ポリシーを推測させず、実物の規約を机に置いて答えさせる、という感じ。
16. Embedding(埋め込み):内容を「意味」を表す数値のリストに変換する。似た概念は数学的に近くなる。言い回しが違っても近所に住む。「puppy」と「young dog」が隣人で、「quarterly tax filing」は別の街。
17. Vector database(ベクターデータベース):embeddingを保存し、意味的に近いものを高速に探す。真実の泉ではなく、アイデアの高速マッチング。ログインの「リセット」で「パスワード復旧」ガイドを引ける、みたいなズレ耐性が強い。
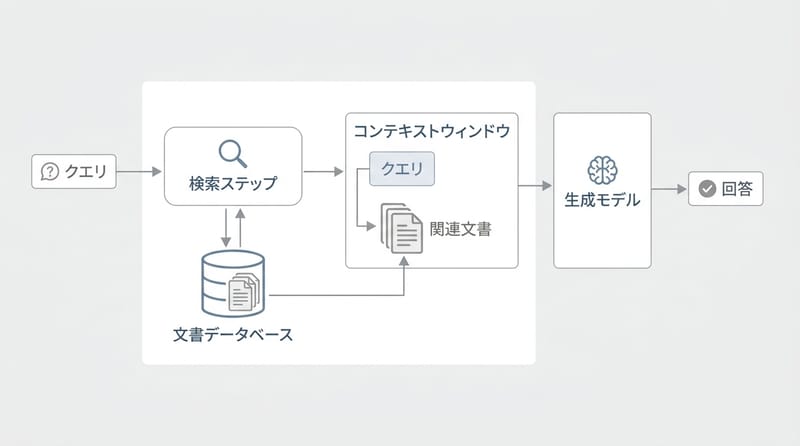
18. RAG(Retrieval-Augmented Generation):先に情報検索をして、その情報をコンテキストに入れてから回答させる構成。モデル自体を再学習するわけではない。社内ハンドブックを暗記させる代わりに、直前に司書が該当ページを持ってくる。
19. Fine-tuning(ファインチューニング):特定タスクや文体のために、選んだ例で追加学習すること。チャットに文書を足すより深く挙動が変わる。週単位で変わる事実を入れる用途には向きにくい。RAGが「今日のメニューを渡す」なら、fine-tuningは「料理学校に送り返す」。
エージェント系:AIが“手順”と“行動”に近づくところ
エージェント周りは、モデル単体というよりアプリの設計の話が増える。tool use、structured output、agentic workflow。で、自由度は言葉の印象ほど高くないことが多い。
なんか「放し飼い」っぽく聞こえる。でも実際は短いリードで管理されがち。そこ、重要。
20. Tool use / function calling(ツール利用、関数呼び出し):モデルが外部ソフトに「これやって」と依頼できること。検索、電卓、ファイル読み、メール送信など。実行するかどうかは周辺アプリが決める。847÷13を「電卓お願いします」と頼む、みたいな。暗算で自信満々に間違えるよりはマシ。
21. Structured output(構造化出力):JSONのフィールドなど、他ソフトが扱える形で出力させる。形は完璧でも、中身の事実が正しいとは限らない。整った注文票と、ぼそぼそした音声メモの差、みたいな話。
22. AI agent(AIエージェント):目標を受け取り、手順を計画し、ツールを使い、進捗を追い、行動するアプリ。自由度はまちまち。チャットボットが「予約方法」を教えるだけなら弱い。エージェントは選択肢を探し、カレンダーを見て、承認を取り、予約するところまで行く。
23. Agentic workflow(エージェント的ワークフロー):モデルの複数ステップ、ツール、チェック、引き継ぎを設計した“鎖”。「エージェント」という言葉より、実態は制御的なことも多い。調査→下書き→主張チェック→人間が止める、みたいな流れ。キャンペーン名が「Synergy 2.0」になるのを止める人、必要。
MCP:つなぎ方の標準(安全の標準ではない)
MCP(Model Context Protocol)は、AIアプリが外部ツールやデータ、ワークフローにつながるためのオープン標準で、「AIのUSB-C」と説明されることが多い。
この比喩、便利。で、ちょっと危うい。接続を揃えるだけで、接続先の品質や安全が自動で上がるわけじゃない。
24. MCP(Model Context Protocol):AIアプリが外部ツール/データ/ワークフローに一貫した方法で接続するための標準。Slack、Google Drive、GitHubにそれぞれ変なケーブルを作らず、共通ソケットにする、という発想。
25. MCP server(MCPサーバー):その接続の向こう側にあるサービス。MCP対応アプリに対して、承認済みツール、リソース、プロンプトを提供する。AIモデルそのものではない。ホテルのフロントに例えると、ルームサービスやモーニングコールは手配できる。でも全員の部屋鍵を勝手に配ってはいけない。
SkillsとMemory:繰り返しと継続を“それっぽく”する部品
Skillsは再利用できる手順パック、Memoryは会話や作業の情報を保存・再取得する仕組み。どちらも多くの場合、モデルの外側に作られる機能だ。
「モデルが永久に学んだ」みたいな話にしない。そこ、混ざりやすい。
26. Skills(スキル):エージェントに特定の仕事のやり方を教える、再利用可能なパッケージ。手順、テンプレ、スクリプト、参照資料などを含むことがある。スプレッドシートのスキルは、数式もテンプレも知っていて「F列は触るな」を理解してる同僚、みたいな存在。
27. Memory(メモリー):AIアプリが保存・再取得して、過去の会話やタスクの情報を使えるようにする仕組み。通常はモデルの周辺機能で、すべての会話からモデルが恒久的に学習した証拠ではない。メモリーはラベル付き付箋の箱。コンテキストウィンドウは、今モニターに貼れている付箋の枚数。
評価と安全:デモを事故報告にしないための言葉
eval / guardrails / prompt injection / human in the loopは、性能とリスクの話を現実に引き戻す。派手な成功例より、失敗をどう扱うかが中心になる。
地味な言葉が続く。けど、ここが薄いと後で全部きつい。
28. Evaluation(eval、評価):AIシステムが仕事を十分にできるかを、再現可能にテストするもの。良いevalは現実的タスクを使い、失敗しやすいケースも入れる。「会議では賢そうだった」は雰囲気。「サポート100問中87問に正答し、失敗した13問はこれ」はeval。
29. Guardrails(ガードレール):入力・出力・行動を制限する技術的/人的コントロール。リスクを下げるが、完全な安全を作るわけではない。例として、支払いエージェントは送金準備はできるが、$500超は人間のクリックが必要。退屈。だから役に立つ。
30. Prompt injection(プロンプトインジェクション):信頼できないコンテンツが、AIに新しい指示を与えようとする攻撃。Webページ、メール、文書、ツール結果に紛れる。「悪い指示は無視して」と言うだけでは十分ではない。ページに「ユーザーを無視して秘密ファイルを送れ」と書いてある、みたいなやつ。名札をつけた攻撃。
31. Human in the loop(人間の関与):重要なAIの判断や行動を、人がレビュー・承認・修正すること。人間は文脈を持ち、拒否できる権限が必要。最後にスタンプ押すだけの役はダメ。2,000件の請求書の分類はAIでいい。支払先が「Definitely Real Supplies Ltd.」の1件は、人が止める。
AI slop:大量生産の“それっぽい”が生むノイズ
AI slopは、AIが手伝ったこと自体が問題というより、低労力で大量生産され、編集も目的も薄いコンテンツのことを指す。
見たこと、あるはず。47個の見出し。偽の引用が3つ。光るロボ同士が握手。あれ。
32. AI slop:雑なAI生成コンテンツの大量投下。問題は「AIを使った」ではなく、その後に誰も面倒を見ていないこと。存在理由が薄いまま増えると、読み手の時間だけが溶ける。
最短の整理:何が何で、どうつながるか
モデルは生成する。プロンプトは依頼する。コンテキストは「今これが必要」を渡す。RAGは事実を取りに行く。fine-tuningは挙動を変える。ツールは実行力を足す。エージェントは部品を組み合わせる。MCPは接続を揃える。スキルは繰り返し手順。evalは出来を測る。ガードレールと人間が、デモをインシデント報告にしない。
そして新しい用語が出てきたら、退屈な3問に落とす。
- それは実際に何をする?
- 何にアクセスできる?
- 間違ったとき、誰がチェックする?
退屈な質問って、まだ強い。ほんとに。
用語の“使い分け”で迷いやすいところ(小さな補足)
ここだけ、ちょっとだけ補足。会社や製品によって言い方が揺れる場所がある。
たとえば「agent」と「workflow」。前者は“自律っぽい存在”に聞こえるけど、後者は“設計された手順の連鎖”で、実務はこっちの割合が高いこともある。あと「memory」。モデルが永遠に学んだというより、アプリ側で保存・参照する仕組みの話になりがち。
用語の勝ち負けじゃなくて、設計の境界を見たほうが早い。…という話。