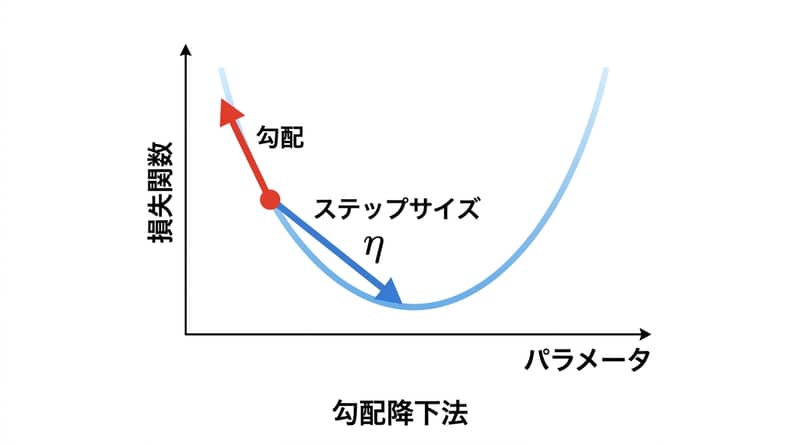
Gradient Descentは、損失関数の勾配(gradient)を手掛かりに、学習率(learning rate, η)で歩幅を決めてパラメータを反復更新し、損失を最小化(minimize)へ近づける最適化手法です。
Machine Learningの「学習」を、モデル当てはめの話としてではなく、optimization problemとして扱う——この視点があると、線形でもニューラルでも、やっていることの芯が揃います。ちょっと言い方を変えると、モデルは器で、loss functionが「どれだけ外したか」を定義して、訓練アルゴリズムはそのlossを下げに行く役。淡々と。
機械学習の学習は「損失を最小化する最適化問題」
モデル学習は、parameters(パラメータ)を動かしてloss function(損失関数)を最小化する最適化問題として書けます。
linear regressionなら、入力 (x) から prediction(予測)(ŷ / y_hat) を作ります。パラメータは slope (m) と intercept (b)。で、予測と実測のズレを測るために Mean Squared Error(MSE)みたいな損失を置く。ここまでが「何を良しとするか」の定義。
そして「どうやって最小値を見つけるか」。単純な線形回帰なら Ordinary Least Squares(OLS)で解析解(closed-form / analytical solution)を出せます。でも、パラメータが何千・何百万と増える、あるいは多くのモデルで便利な閉形式解がそもそも無い、となると別の道が必要になる。Gradient Descentが出番になります。
なぜGradient Descentが必要になるのか(OLSとの対比)
Ordinary Least Squaresは、線形回帰の損失最小化を「式で一気に解く」解析的アプローチで、Gradient Descentは「反復で近づく」数値的アプローチです。
OLSが使える状況ならそれで良い、という話は残ります。小さな問題なら合理的です。ただ、特徴量やパラメータが増えるほど、解析的に解くための計算(行列演算)が重くなったり、そもそも閉形式解が用意できないモデルに出会う。そうなると、直接「最小値を計算する」より、更新を繰り返して「最小値へ寄せる」ほうが設計として汎用になります。
ここで大事なのは、Gradient Descentは linear regression専用ではなく、optimization algorithmだという位置づけです。lossが微分できて、gradientが計算できるなら、適用できる余地がある。logistic regressionでも、neural networksでも、原理は同じ側にいます。
直感:山を下る比喩で押さえる4つの対応
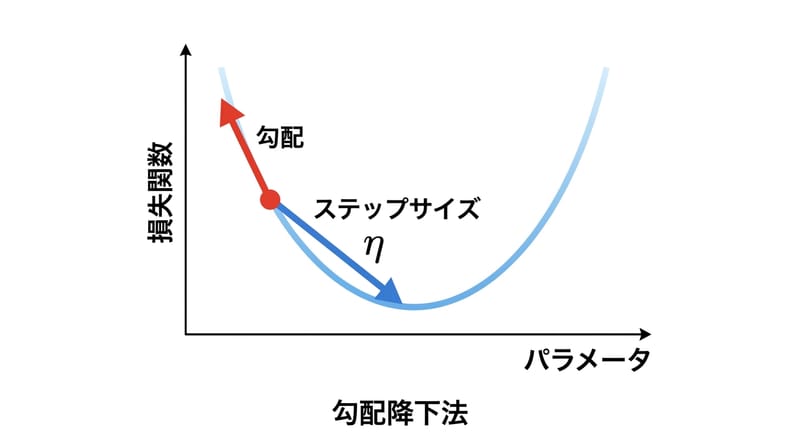
Gradient Descentは、「今いる場所の傾き」だけを見て、次の一歩を決める反復法です。
よくある比喩を、そのまま対応表として固定すると迷いにくいです。
山(地形)=loss function(損失関数)
現在地=現在のparameters(パラメータ値)
足元の傾き=gradient(勾配)
歩幅=learning rate(η)
全部見渡せない。だから局所情報で動く。で、歩いてまた傾きを測る。これを繰り返して、平らになってきたら(損失の改善やパラメータ変化が小さくなったら)止める、みたいな発想になります。
1パラメータから始める:intercept (b) だけを動かす
m=78.35を固定し、intercept (b) だけをGradient Descentで最適化すると、更新の意味が追いやすくなります。
原文の流れに沿って、まず「片方だけ」やります。m=78.35 を既知(固定)とし、モデルを y_hat = 78.35x + b にする。残る未知は b だけ。MSEを b の関数として見ると、線形回帰+MSEの設定ではボウル状(bowl-shaped)の曲線になり、底が最小値。
ここで疑問は単純で、「右にいるのか左にいるのか、どう判断する?」になります。そこで derivative(導関数)です。
derivative / partial derivative:勾配が「増える方向」を指す
勾配(gradient)は損失が最も増える方向を指すため、損失を最小化したい場合は勾配の反対方向へ更新します(更新式にマイナス符号が入る理由)。
1変数なら derivative が「その点での傾き」を返します。右側にいると傾きが正で、右へ行くほどlossが増える。だから左へ戻る。左側にいると傾きが負で、右へ行くほどlossが減る。だから右へ進めばいい。要するに、傾きの符号が「どっちへ動けば損失が減るか」を教える。
多変数になると partial derivative(偏導関数)を並べてベクトルにしたものが gradient です。ここで重要なのは、gradientが「増加の最急方向」を指す、という点。最小化なら逆向きへ。だから update rule の基本形が、引き算(マイナス)になります。
MSEでの勾配:b と m の式の違い(chain ruleの位置)
線形回帰のMSEでは、bに関する勾配は残差の総和に比例し、mに関する勾配は残差にx_iを掛けた総和に比例します。
原文は数式がレンダリング前提で欠ける箇所があるので、意図されている関係だけ明示します。lossはMSEで、予測は y_hat = m x + b。bだけを動かすなら、lossをbで偏微分して更新に使う。ここで chain rule(連鎖律)が出てきて、「二乗の外側」と「中の (y - m x - b)」がつながる、という構造です。
2パラメータに拡張すると、偏導関数が2本になります。
b について:残差 (y - m x - b) の項がそのまま効く(x_iは付かない)
m について:中身を m で微分するので x_i が追加で掛かる
この「mの勾配だけ x_i が付く」差分が、後で feature scaling の話につながってきます。急に。ほんとに。
更新式(update rule)とlearning rate(η)がやっていること
Gradient Descentの更新は、現在のパラメータから「学習率×勾配」を引いて行い、学習率が小さすぎると収束が遅く、大きすぎるとovershootやoscillate、divergeの可能性が高まります。
一般形は、パラメータ θ に対して θ ← θ − η (∂L/∂θ)。bなら b ← b − η (∂L/∂b)。mも同様。やってることは、勾配の大きさに比例した量だけ動く、ただし歩幅は η でスケールする、です。
原文の数値例はこの直感を固定するためのものなので、そのまま残します。
現在 b=100、gradient=50、learning rate=0.1 なら、0.1×50=5 なので b は 5 だけ更新される
learning rate=1 なら 1×50=50 で、更新量が一気に大きくなる
learning rate が小さすぎる→収束(converge)が遅い。大きすぎる→最小値を飛び越える(overshoot)→振動(oscillate)したり、発散(diverge)する可能性。ここは、言い切りじゃなくて「可能性」までに留めるのがポイントです。実際、地形(loss surface)次第なので。
Pythonで「一回だけ」更新してみる:make_regression → LinearRegression → 手動更新
scikit-learnのmake_regressionで小さな回帰データを作り、LinearRegressionでOLSの結果を見たうえで、m=78.35・b=100からbを1回更新する流れは、GDの反復更新を最小単位に分解した例です。
原文のコードは言語タグが混在していたので、Pythonとして読める形に寄せて整形します(内容は同じ範囲)。まずデータ生成です。
from sklearn.datasets import make_regression
import numpy as np

X, y = make_regression(
    n_samples=4,
    n_features=1,
    n_informative=1,
    n_targets=1,
    noise=80,
    random_state=13
)
次に、解析的アプローチとして scikit-learn の LinearRegression(OLS相当)で係数を確認します。
from sklearn.linear_model import LinearRegression

reg = LinearRegression()
reg.fit(X, y)

print(reg.coef_)
print(reg.intercept_)
ここから「最適なinterceptを知らないことにして」、m=78.35 を固定し、b=100 から始める。
m = 78.35
b = 100
b に関する勾配(原文では loss_slope)を計算し、learning rate(lr)を置いて、step_size を作って、b を更新する。1回だけ。
loss_slope = -2 * np.sum(
    y - m * X.ravel() - b
)

lr = 0.1
step_size = lr * loss_slope
b = b - step_size
これで「1 iteration」。繰り返せば、少しずつ b が動いていく。まあ、当たり前なんだけど、この当たり前が大事で、反復(iterative)であることがそのまま学習の形になります。
1パラメータ→2パラメータ:損失曲線から損失曲面へ
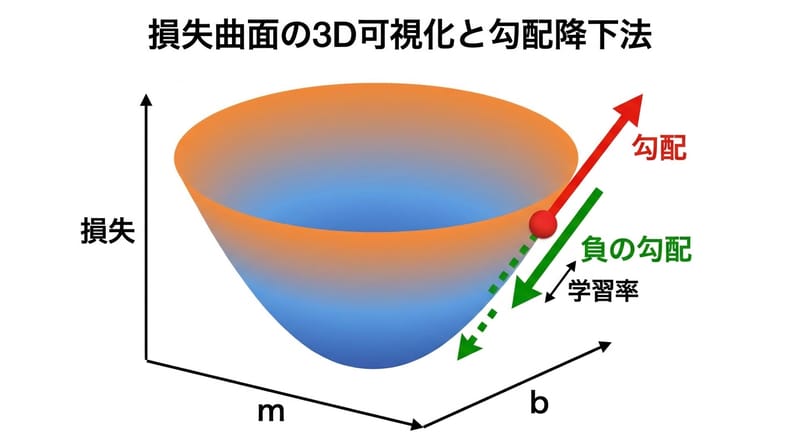
mとbの2パラメータを同時に最適化すると、lossはL(m,b)となり、勾配は2つの偏導関数からなるベクトルになって、更新はその反対方向へ進みます。
1変数のときは曲線の上を歩く話でした。2変数になると、頭の中の図は「3次元のloss surface」。横軸が (m) と (b)、縦がloss。ボウル状の面のどこかに立って、底を探す。
勾配はベクトルです。∂L/∂m と ∂L/∂b をまとめたもの。gradient が「最急増加方向」を指すので、最小化ではマイナス方向へ進む。更新式のマイナス符号は、飾りじゃない。方向そのものです。
そして、先ほどの差分がここで効く。m側の偏導関数には x_i が掛かる。b側には掛からない。この構造のせいで、特徴量のスケールが暴れていると、mの更新が極端になったり、地形が細長く見えたりする。そういう繋がり。
GDRegressor:最小実装(intentionally simple)で反復を見える形にする
GDRegressorは、勾配計算→学習率でスケール→mとbを更新、をepochs回繰り返すだけのシンプルなGradient Descent実装です。
原文は「意図的に単純(intentionally simple)」と明言していて、そこが大事です。現実の実装は最適化や周辺機能が追加されますが、核は変わらない、という主張を保ちます。コードはインデントが崩れていたので、同じ内容のまま整えます(初期値 m=100, b=-120 も保持)。
import numpy as np

class GDRegressor:
    def __init__(self, learning_rate, epochs):
        self.m = 100
        self.b = -120
        self.lr = learning_rate
        self.epochs = epochs

    def fit(self, X, y):
        for i in range(self.epochs):
            loss_slope_b = -2 * np.sum(
                y - self.m * X.ravel() - self.b
            )

            loss_slope_m = -2 * np.sum(
                (y - self.m * X.ravel() - self.b) * X.ravel()
            )

            self.b = self.b - (self.lr * loss_slope_b)
            self.m = self.m - (self.lr * loss_slope_m)

    def predict(self, X):
        return self.m * X + self.b
インスタンス生成と学習の呼び出しは、原文の通りです。
gd = GDRegressor(
    learning_rate=0.001,
    epochs=50
)

gd.fit(X_train, y_train)

y_pred = gd.predict(X_test)
X_train / X_test の定義は原文内に出てこないので、ここでは「どこかで分割した前提」以上のことは言えません。読み手の側では、学習用とテスト用に分けたX,yを渡す、という理解で止めるのが安全です。余計な補完はしない。
epochsと停止条件:回数固定とconvergence criterion(early stopping)
epochsは更新を何回繰り返すかを決める回数で、epochs=1000のように固定回数で止める方法に加え、パラメータ変化や損失改善が小さいことをconvergence criterionとしてearly stoppingする考え方があります。
実装上は for i in range(self.epochs): の回数が epochs。1 epoch で「全データを使って勾配を計算して1回更新する」設計だ、と原文は説明しています(この particular implementation では、という限定付き)。
で、回数を増やせば良いかというと、そうでもない。既に収束しているなら計算資源の無駄になる可能性がある。だから停止条件が要る、という流れ。
止め方は2系統。
固定回数:epochs=1000 のように最初から決める
変化量を見る:パラメータがほとんど変わらない、あるいはlossの改善がほとんど無いなら止める(convergence criterion / early stopping)
「ほとんど」の閾値の決め方は原文では踏み込んでいないので、ここも踏み込まない。決められる、という話まで。
feature scalingが効く理由:細長い地形とジグザグ
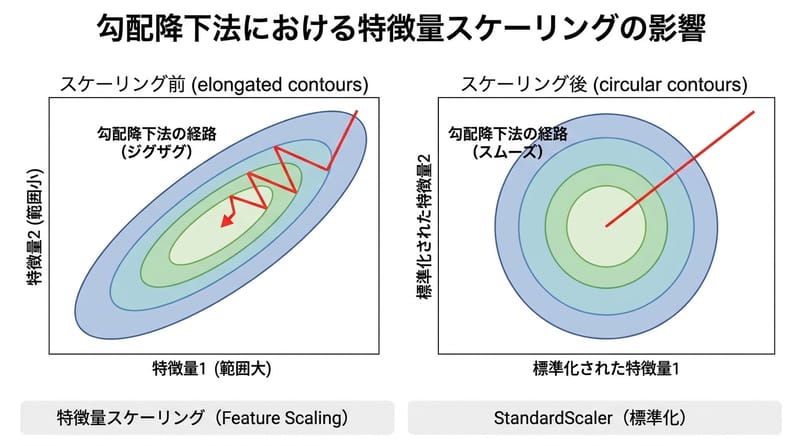
特徴量スケールが大きく異なると損失地形が細長くなりGradient Descentがジグザグしやすく、StandardScalerによるstandardizationは問題条件を改善して収束を速めることがあります。
例として、Age: 18 to 80 と Income: ₹20,000 to ₹2,000,000。スケールが違いすぎる。こういう入力をそのまま使うと、loss surface が「バランスの良いボウル」ではなく、細長く伸びた谷(narrow valley)みたいになりやすい、と原文は述べます。
細長い谷で最急降下方向に一歩踏むと、片側に寄りすぎる。次の勾配は反対側へ強く向く。結果、左右に跳ねながら(zig-zag)じわじわ底へ進む。進んでるけど効率が悪い、という状態。
そこで feature scaling。standardization(標準化)として StandardScaler を使う例が提示されています。
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
標準化は、特徴量を0中心にし、標準偏差に基づいてスケールを揃える。これにより最適化問題が better-conditioned になり、Gradient Descent が速く収束しやすい、という主張です。ここも「しやすい」で止める。データ次第なので。
凸・非凸:linear regressionとneural networksで難しさが変わる
MSEのlinear regressionは凸(convex)で大域最小(global minimum)が一つですが、neural networksのような非凸(non-convex)では局所解(local minima)、saddle points、平坦部があり最適化が難しくなります。
線形回帰+MSEは convex optimization problem。損失曲面が凸なら、最小値は一つ(global minimum)。だから、if Gradient Descent converges properly(適切に収束するなら)そこへ到達できる、という整理になります。条件付きです。初期値や学習率などが雑だと、そもそも収束が崩れることはあり得る。
一方、現代のモデル、特に neural networks は non-convex が一般的で、局所的な谷、鞍点、平らな領域が混ざる。最適化が難しくなる。ただし、原理は変わらない。backpropagation が勾配を計算し、最適化アルゴリズムがその勾配で重みを更新する。結局そこへ戻る。
Batch / Stochastic / Mini-Batch:更新に使うデータ量の違い
Batch Gradient Descentは全データで勾配を計算して安定だが高コストになりやすく、Stochastic Gradient Descentは1サンプルで頻繁に更新する代わりにノイズが大きく、Mini-Batch Gradient Descentはbatch size=32などで両者の折衷を取ります。
原文の実装は全データで勾配を計算してから1回更新するので Batch Gradient Descent。更新は比較的安定しやすい一方、データが巨大だと毎回全件を舐めるコストが効いてくる。
Stochastic Gradient Descent(SGD)は1つの訓練例で更新する。更新回数は増えるし速いテンポで動くけど、勾配推定のばらつき(ノイズ)が大きくなる。
Mini-Batch Gradient Descent はその中間。たとえば batch size=32 のように小さな塊で更新する。安定性と更新頻度の折衷で、neural networks の学習では一般的に使われる、という位置づけです(ここも「一般的」で留める)。
適用範囲:Gradient Descentは線形回帰に限らない
Gradient Descentはlinear regressionに限らず、logistic regressionやneural networksのように微分可能な損失と勾配が得られるモデルで、パラメータ更新の基本機構として使われます。
線形回帰の (m,b) は、勾配で動かせる「分かりやすい教材」になっているだけ。logistic regression では log loss を最小化する方向にパラメータを更新する。neural networks では backpropagation が勾配を計算して、最適化が重みを更新する。
つまり、同じ仕組みが、規模と形を変えて繰り返し現れる。学習っていうより、最適化の反復手順、というほうが近い場面もある。まあ、言い方の問題だけど。
結論:更新は「勾配の反対方向へ一歩」を繰り返すだけ
Gradient Descentの本質は、損失の勾配を計算し、学習率でスケールして、勾配の反対方向へパラメータを反復更新し続けることです。
最後に残るのは、派手さのない反復です。初期値から始める(ランダムでもよい、という性質は原文でも触れられています)。予測を作る。lossを計算する。gradientを計算する。update ruleで (m,b) を更新する。これを繰り返す。
「底がどこか」を最初から知る必要はない。局所の傾きで、次の一歩を決める。それだけで、損失を下げる方向へ進める可能性がある。そこが強い。で、同時に、learning rate や feature scaling みたいな実務上の条件で挙動がかなり変わる。ここを雑にすると、簡単に振動したり発散したりする。ほんと、地形次第。